仪表盘
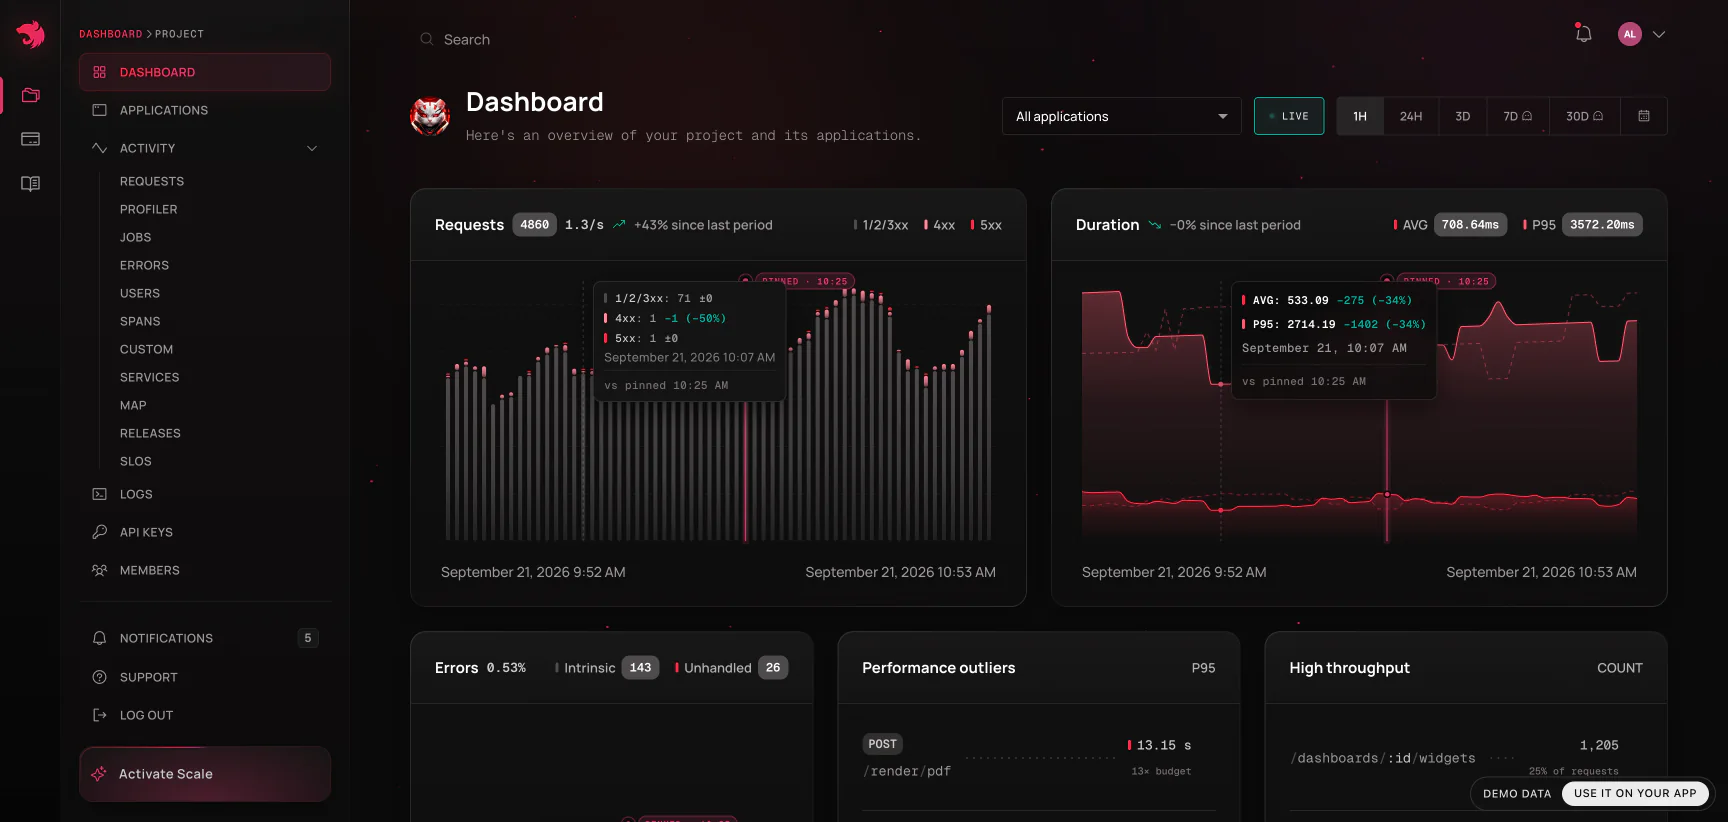
当应用程序完成插桩并开始发送数据后,它的项目仪表盘会自动填充——无需编写查询,无需搭建仪表盘。本章介绍每个视图展示什么、它们彼此之间如何关联,以及构建在遥测数据之上的各项功能——告警、SLO、问题和代理交接——如何协同配合。完整参考请见 NestJS Observe 文档。
视图的层级关系
几乎所有遥测视图都属于以下三个层级之一,您可以通过点击在它们之间逐层深入:
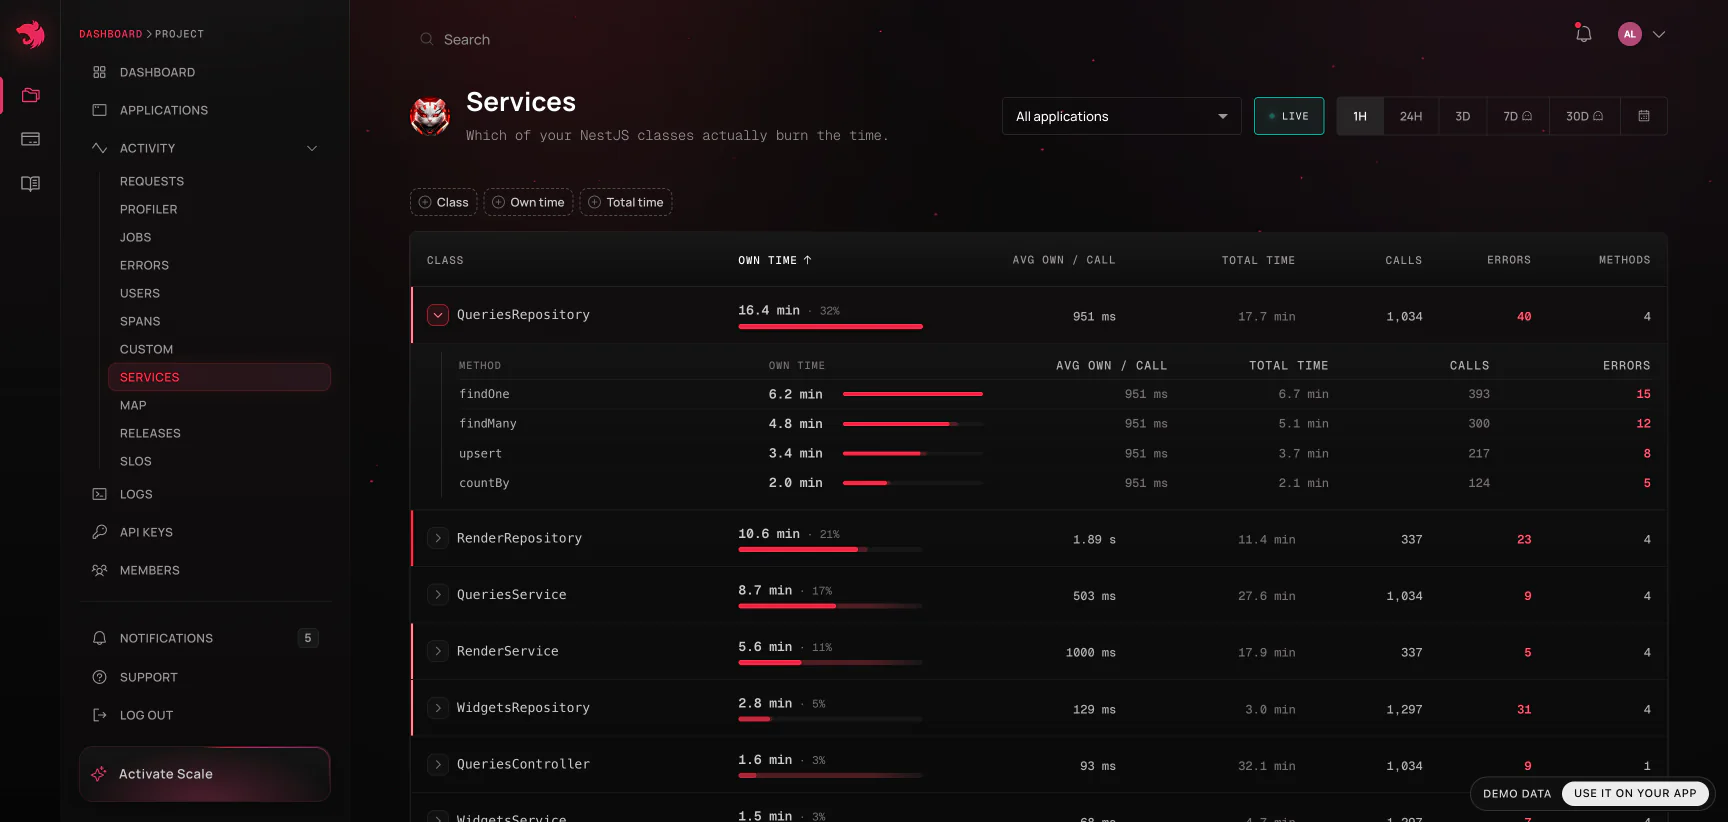
- 分析(Analytics)——列表视图。在所选时间窗口内,您的应用程序上报的每条路由、任务、跨度或指标的聚合数据:吞吐量、延迟、失败率。这里是您注意到异常的地方。
- 操作(Operation)——一条路由(
GET /orders/:id)、一个任务名或一个跨度名。同样的指标随时间的变化,加上其背后的单次执行列表。这里是您确认问题形态的地方:恒定还是突发、普遍存在还是始于某次发布。 - 执行(Execution)——单个请求、单次任务运行、单次跨度调用。它的确切耗时、状态、用户、标签、抛出的错误、它所做的一切的瀑布图,以及它写入的日志。这里是您诊断问题的地方。
聚合数据告诉您_是否_出了问题以及影响多大;而单次执行告诉您_为什么_。每个视图共享同一根控制栏——时间范围和可选的应用程序筛选器——页面上的一切都服从于它。
遥测视图
将故障交给编码代理
读懂一条追踪告诉您发生了什么。而下一步永远相同:找到那段代码并修改它。复制代理提示词 按钮一键完成这次交接——它把整个页面复制为一段自包含的 markdown 提示词,可以直接粘贴到 Claude Code、Cursor 或任何打开了您仓库的工具中。
该按钮只在确有可调查之物时出现:失败或比 95% 的同类更慢的请求或任务,或者包含错误的追踪。提示词携带任务框架、操作上下文、错误及其裁剪后的堆栈跟踪和源代码行(路径已改写为相对于您项目根目录的形式,即 src/orders/orders.service.ts:35 而不是 /var/app/current/dist/orders/orders.service.js:35)、这次调用与操作平均值和 p95 的对比、按自有时间排名的头部跨度、最多 40 行以错误优先挑选的日志,以及结尾的指示——要求代理从代码出发解释根本原因,并提出一个附带测试的 diff 形式的修复方案。
对于需要持续追问的代理——沿着追踪查它的日志、确认某个错误是否仍在触发——请改为把它连接到 MCP 服务器。
告警
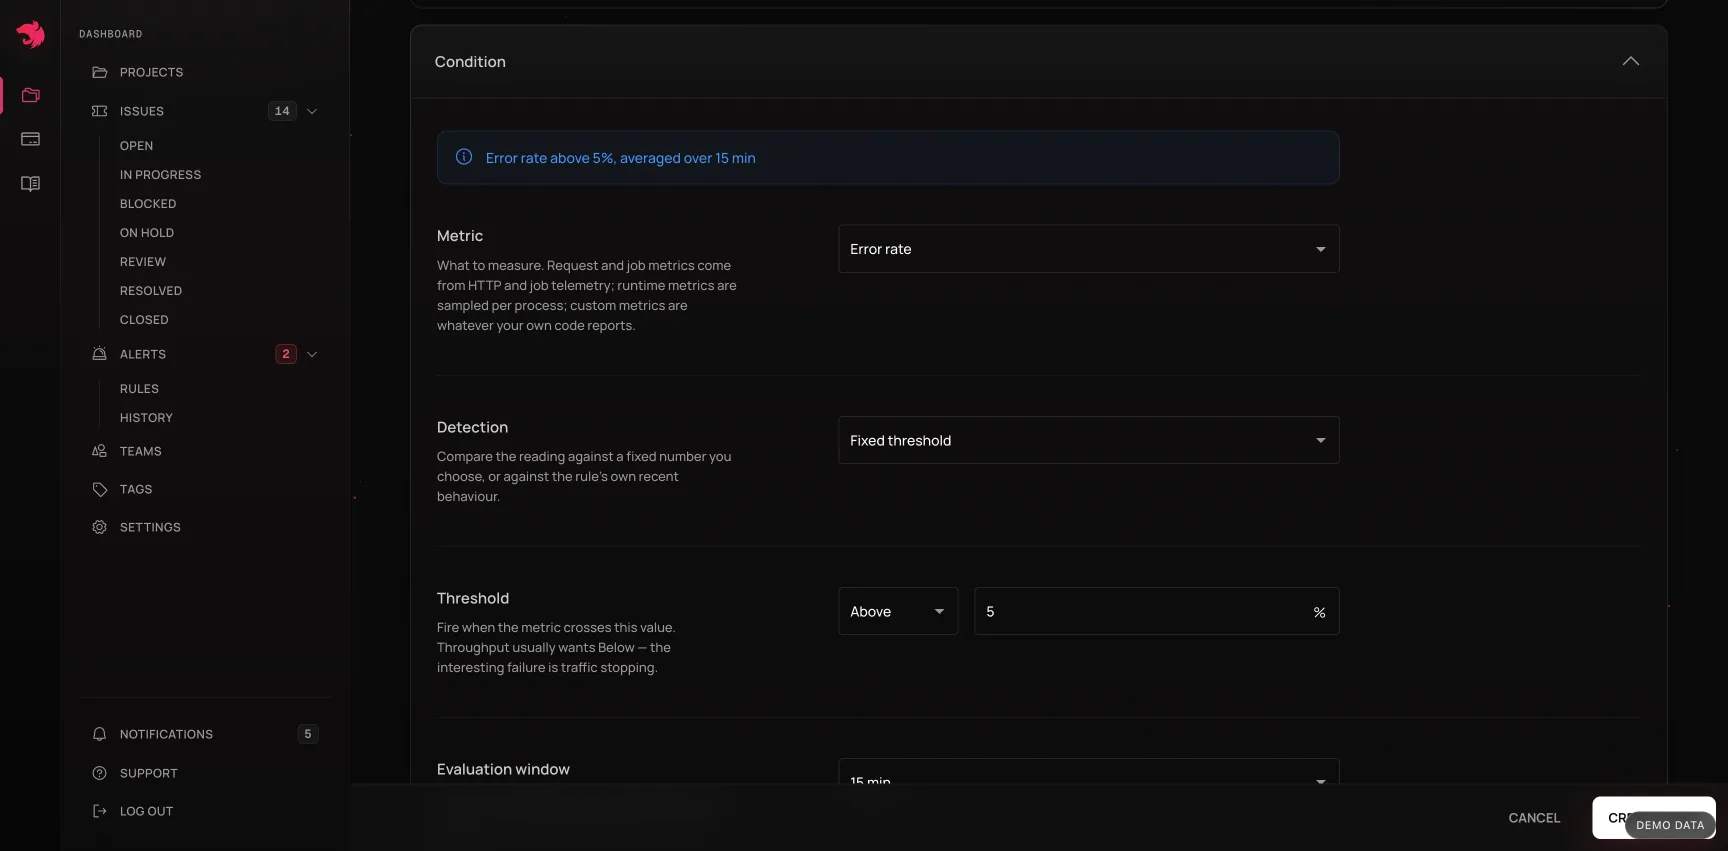
告警让您在遥测数据越过您关心的阈值时被告知,而不是从客户那里才得知。一条规则监视来自以下类别之一的某个指标:
每条规则以两种模式之一运行:固定阈值("错误率高于 5%"),或异常检测——当指标偏离其自身近期基线超过您设定的敏感度时触发。对于运行时指标,异常检测往往是更好的选择——适合某个服务的固定 CPU 阈值对下一个服务就是错的,而"不同于它自己近期的基线"这一标准到处适用。
从插桩的角度看,有两个类别值得仔细了解:
- 缺失检测。 遥测静默 规则监视 SDK 的
runtimeMetrics采样器发出的运行时心跳——即使应用程序在其他方面完全空闲,心跳也会发出——一旦静默时间超过您设置的容忍度(2 分钟到 7 天)就触发。任务静默 规则对某个具名任务做同样的事——比如一个没有运行的定时任务。这既是无需外部探针的轻量级运行时间监控,也是定时任务监控,全部来自同一机制。从未上报过任何数据的作用域不会触发:"尚未接入"不等于"宕机"。 - 日志模式告警 统计窗口内包含某子串的日志行——"当
payment declined在 15 分钟内出现超过 10 次时提醒我"——并且需要开启forwardLogs。
规则可以通过电子邮件、Slack(incoming webhook)、通用 webhook、应用内通知,或通过创建一个问题(预填规则的严重级别和作用域)来通知。规则可以携带用于免打扰时段的周期性静默时间表,并且每一次状态转换(OK → 触发 → 已解决)都会连同每个渠道的送达状态一起被记录。
SLO
SLO 把"错误率高于 5%"变成"我们承诺了 99.9%,而预算消耗得太快"。它们是针对您已在收集的遥测数据设定的目标——不需要任何新的插桩。一个 SLO 由三层递进的概念构成:
- SLI(服务级别指标)——在某个窗口内好事件与总事件之比:可用性(没有未处理错误的请求)、延迟(低于您设定阈值的请求)或任务成功。
- 目标——SLI 加上一个目标百分比(90–99.999%),在 7、14、28 或 30 天的滚动合规窗口上计算。
- 错误预算——您还剩多少达不到目标的空间(
1 − target),以及燃烧率——预算被消耗的速度。燃烧率 1.0 恰好按计划耗尽预算;14.4 意味着一个 28 天的预算会在大约两天内耗尽。
燃烧率告警是一条指向某个 SLO 而非原始指标的普通告警规则。典型的起点是一条快烧规则(1 小时窗口,14.4 倍)、一条慢烧规则(6 小时,6 倍)和一条涓流规则(3 天,1 倍)。合规窗口不能超过您的套餐保留遥测数据的时长。
问题
问题(Issues)是对从遥测中产生的工作进行的轻量级、项目级跟踪——一个值得修复的反复出现的错误、一个有待调查的延迟回归。您可以从任意执行页面手动创建,把一个错误分组提升为问题,或者让触发的告警自动开启一个。问题会链接到它所来源的请求、错误、任务或追踪,因此任何后来打开它的人都能在上下文中看到遥测数据,而不只是对它的文字描述。
当您把一个问题标记为已解决、且它指向某个可度量的对象(一个操作、某条告警规则的作用域)时,仪表盘会对照事件发生前的基线观察该操作的遥测数据,并告诉您修复是否真正生效——把问题移入验证中,随后自动关闭,或者带着破坏它的读数退回打开状态。如果您指明了修复随哪个版本发布(您的 serviceVersion),验证会推迟到该版本真正出现在遥测数据中之后。
仪表盘排查路径
这些视图的设计意图就是按顺序走查。一次典型的调查:
- 一条告警触发,或者请求 图表显示 p95 正在攀升。
- 按耗时或失败率对路由列表排序,找出哪个操作发生了变化。
- 打开该操作。它是恒定的还是突发的?是否始于某次部署?查看版本发布。
- 从分布的尾部打开单次执行——基线卡片称之为_比 95% 的调用更慢_的那一种。
- 阅读瀑布图:哪个跨度占有了自有时间?
- 如果它失败了,阅读错误卡片——堆栈跟踪以及抛出点附近的源代码行。
- 查看该追踪的日志,悬停各行使其与跨度一一对齐。
- 复制代理提示词,把整件事交给编码代理;或者打开一个链接到该执行的问题,让接手的人从您停下的地方继续。
当您更想提问而不是逐一点击时,同样的走查也可以由代理通过 MCP 服务器完成——每一步对应一个工具。