分布式追踪
追踪(trace) 是您的应用程序在同一个追踪 ID 下记录的全部内容:发起它的请求或任务,以及其下的每一个跨度。在单个服务内部,这一切是自动的——SDK 会在工作开始时生成一个追踪 ID,其下的每个跨度(包括您通过 TracerService 手动添加的跨度)都会继承它。
而在跨服务的场景下,默认并不自动。一个触及多个服务的用户操作——一次扇出到 gRPC 服务的 API 调用、一个回调另一个应用程序的任务——只有在所有相关服务最终使用同一个追踪 ID 时,才会在您的仪表盘中显示为一个追踪。如果不做配置,每个服务都会通过 traceIdGenerator 生成自己的 ID,这个操作就会显示为若干互不相连的追踪,每个服务一个。
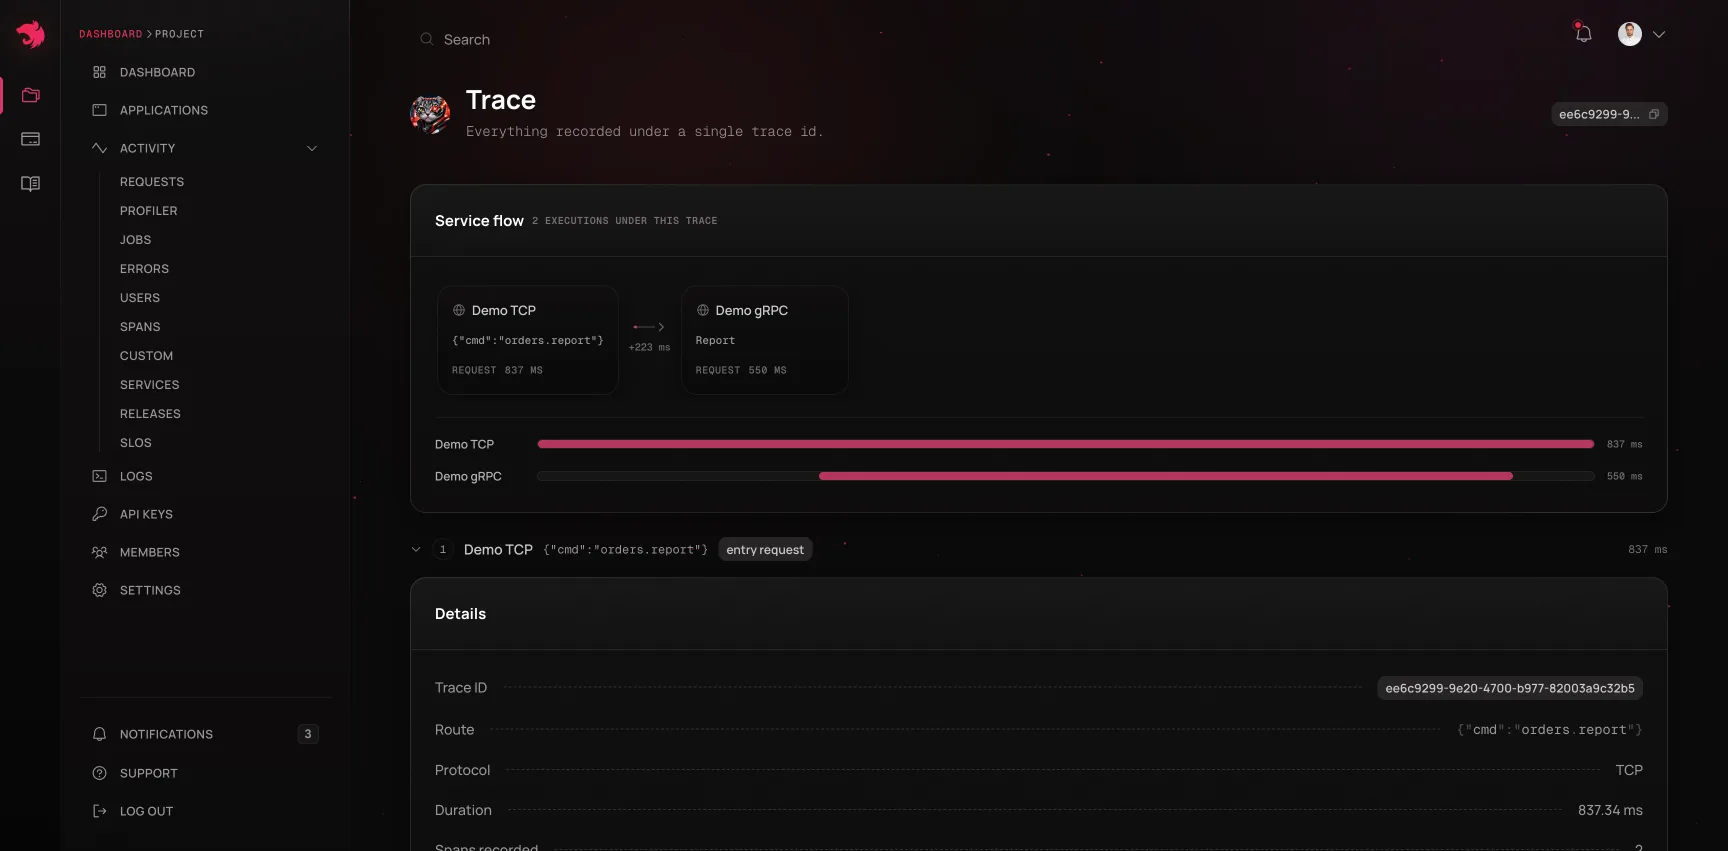
转发追踪 ID 是应用程序代码的事,不是仪表盘里的设置。模式始终相同:调用方把它当前的追踪 ID 放到该协议所提供的信道上,被调用方的 traceIdGenerator 再把它读出来。本页针对每种传输器演示这一做法。
读取当前追踪 ID
要把追踪 ID 向下游转发,服务首先需要读取自己当前正运行在哪个追踪之下。TracerService.currentTraceId() 直接返回它:
它读取的上下文存储与 getAttribute()/setAttribute() 相同,但与它们不同的是,在被追踪上下文之外它不会抛出异常——而是返回 null,因此从启动钩子或其他未被追踪的路径转发追踪 ID 的代码,不需要为了传播一个尚不存在的 ID 而包一层 try/catch。如果您的代码中可能出现这种情况,请在设置请求头之前先对 null 做判断。
HTTP 到 HTTP
无需任何额外配置即可工作。默认的 traceIdGenerator 是 (req) => req.headers['x-request-id'] ?? randomUUID(),因此服务会采用传入请求携带的任何 x-request-id,而不是重新生成一个。在发出的请求上把追踪 ID 作为 x-request-id 转发出去,接收方服务就会接住它:
如果您使用 HTTP 模块,可以在 Axios 请求拦截器中一次性添加同一个请求头,而不必在每个调用点重复:
info 提示 许多反向代理和负载均衡器(nginx、Envoy、AWS ALB)都可以配置为对每个入站请求设置
x-request-id。一旦这样做,您仪表盘中的追踪 ID 就会与代理访问日志中的请求 ID 一致,无需再做任何工作。
gRPC
gRPC 没有请求头,只有元数据(metadata)。调用方把追踪 ID 作为元数据附上,gRPC 服务则重写 traceIdGenerator 把它读出来,因为默认生成器只检查 HTTP 请求头:
关于如何在调用的两侧读取和写入元数据,请参见 gRPC 章节。
TCP、Redis、NATS 及其他微服务传输器
@nestjs/microservices 的传输器没有元数据信道,只有消息负载,因此追踪 ID 必须作为负载内部的一个字段来传递:
生成器接收的是该传输器的上下文对象,因此同一种写法对请求-响应式(send())和事件式(emit())消息都适用。
warning 警告 一个只接收 RPC 调用的服务,其默认的
traceIdGenerator仍然期望一个 HTTP 请求。在同时服务 HTTP 和微服务传输器的混合应用中,请防御性地编写生成器——先检查headers,再回退到负载。
GraphQL
当 GraphQL 服务器位于同一服务的 HTTP 层之后时,不需要任何额外配置——它会自动加入 HTTP 代理已为该请求开启的追踪,而这个追踪本身可能就是通过上述 x-request-id 传播而来的。只有一个不处于任何 HTTP 追踪之内的 GraphQL 服务器——例如一个不涉及 HTTP 代理、直接跑在原生 WebSocket 上的订阅——才需要单独考虑这个问题,而目前还没有针对这种情况的内置传播钩子。
队列任务(BullMQ)
目前无法传播。任务处理器总是会以一个全新的随机 ID 开启自己的新追踪,无论任务入队时哪个追踪处于活动状态——任务没有像 HTTP 和 RPC 那样的 traceIdGenerator 钩子。请把它当作当前的限制,而不是可以通过配置绕过的问题。如果您需要把一次任务运行关联回入队它的请求,请把该请求的追踪 ID 放进任务数据中,并在处理器里把它附加为标签:
任务仍然会拥有自己的追踪,但这个标签是可搜索的,因此从一条缓慢的请求到它触发的任务,一次搜索即可到达。
追踪在仪表盘中的呈现
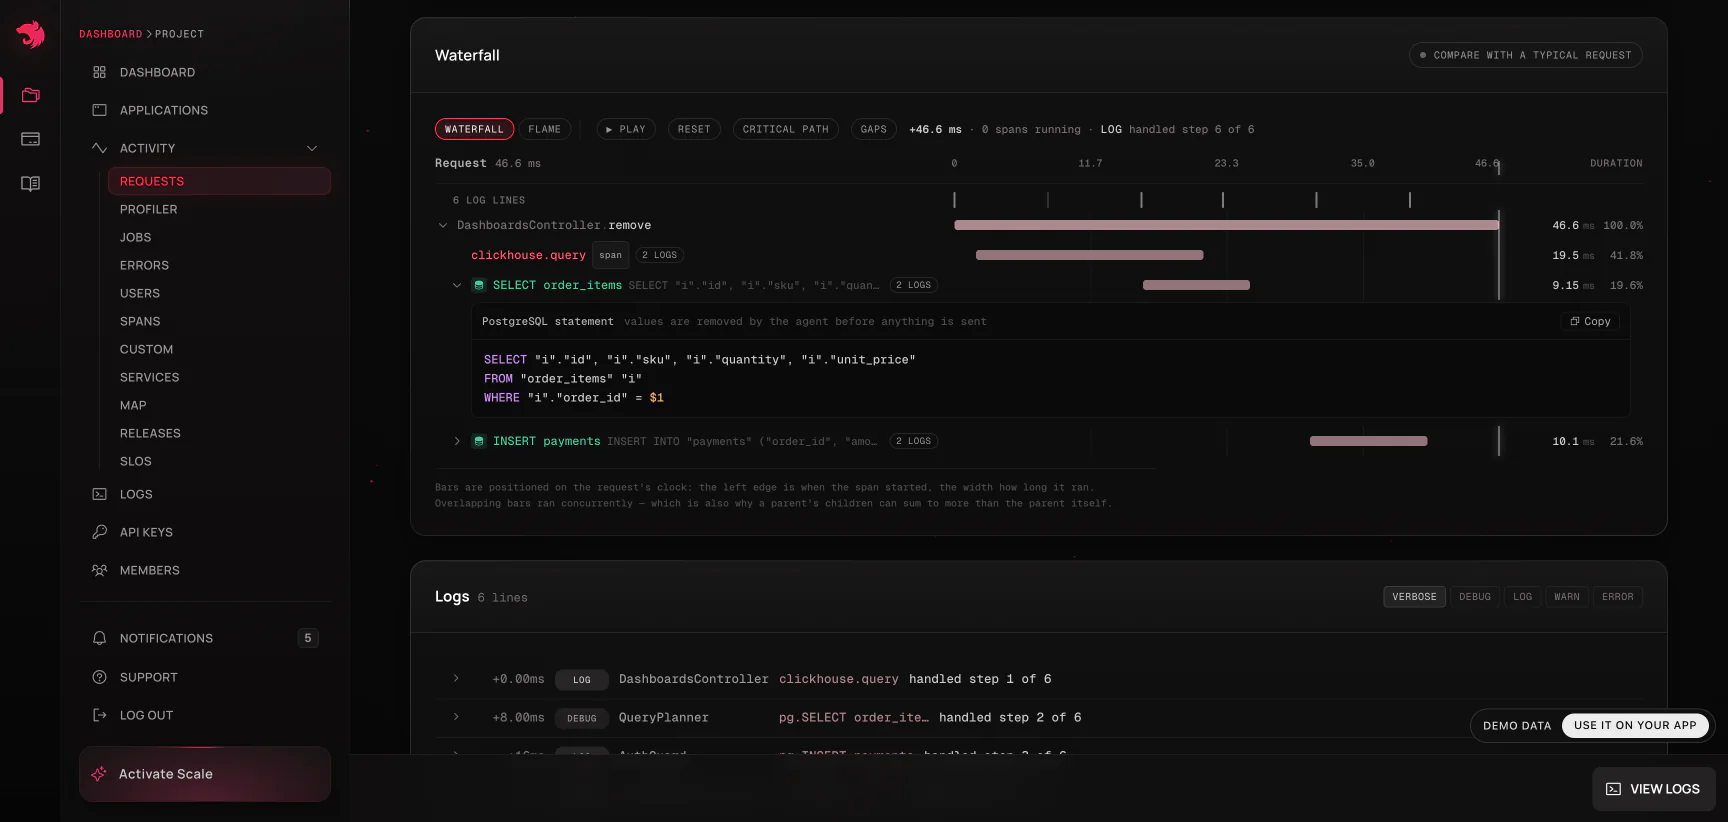
一旦各服务就追踪 ID 达成一致,追踪详情页就会把在其下运行的每一次执行——跨服务、请求和任务——渲染为一幅瀑布图:嵌套深度表现为缩进,持续时间表现为条形长度,位置表现为跨度运行的时刻。阅读它时有几点值得了解:
- 自有时间才是关键数字。 一个跨度的持续时间减去其所有子跨度占用的部分,就是该跨度在自己代码上花费的时间。按总时长排名总是把控制器排在最前面(它包含一切);而按自有时间排名则会浮出真正烧掉时间的那次仓储调用。每个执行页都附带一张按此方式排序的跨度表。
- 重叠的子跨度会被标记。 当一个跨度的子跨度耗时之和超过该跨度自身的持续时间时,说明它们是并发运行的(
Promise.all、并行扇出),该行会注明这一点。 - 失败的跨度会被标记,并且执行页会以第一个抛出异常的跨度的错误卡片开头——类、消息、经过裁剪且标出抛出帧的堆栈跟踪,以及在
sourceContext开启时的周边源代码行。 - 日志落在追踪的时钟上。 启用
forwardLogs后,每一行日志都按其相对追踪起点的偏移定位,并标注写入时正在进行的跨度;悬停某一行会在瀑布图上标记那个瞬间。
在任何失败或异常缓慢的执行页面上,复制代理提示词 按钮都会把整页内容——上下文、错误、带源码的堆栈跟踪、按自有时间排名的头部跨度和日志——打包成一段自包含的 markdown 提示词,供编码代理使用。参见仪表盘。